Chatbot yang Percaya Diri, tapi Salah#
Bayangkan kamu bertanya kepada sebuah chatbot AI: "Proyek apa yang paling bangga dikerjakan oleh pemilik website ini?"
Jawabannya meluncur lancar, rapi, dan meyakinkan. Ada nama proyek, ada teknologi yang dipakai, bahkan ada angka pengguna. Masalahnya satu: semuanya karangan. Model itu tidak pernah membaca portofoliomu. Ia hanya menebak kalimat yang terdengar masuk akal.
Inilah momen ketika banyak developer sadar bahwa memasang AI di aplikasi web itu mudah, tetapi membuatnya menjawab dengan benar itu soal lain.
Kabar baiknya, solusinya tidak harus rumit. Banyak orang mengira integrasi AI itu rumit. Padahal, memanfaatkan AI di aplikasi web sekarang jauh lebih mudah berkat API seperti Gemini dan pendekatan Retrieval-Augmented Generation (RAG). Kamu tidak perlu melatih model sendiri, tidak perlu GPU mahal, dan tidak perlu gelar riset. Kamu butuh pemahaman alur yang jelas dan beberapa ratus baris kode.
Di artikel ini kita akan membahas semuanya dengan bahasa sederhana:
- apa itu RAG dan mengapa ia membuat jawaban AI jauh lebih akurat dan kontekstual,
- bagaimana chunking, embedding, dan vector database bekerja sama,
- bagaimana alur lengkap dari dokumen sampai jawaban,
- contoh nyata: chatbot portofolio yang bisa menjawab pertanyaan tentang pengalaman dan skill,
- kode contoh, tips kualitas, keamanan, biaya, dan kesalahan yang perlu dihindari.
Artikel ini cocok untuk developer web, mahasiswa, freelancer, dan siapa pun yang ingin menambahkan fitur AI yang berguna, bukan sekadar pajangan. Kalau kamu bisa membuat endpoint API dan memahami JSON, kamu sudah punya bekal yang cukup.
Mari mulai dari pertanyaan pertama: mengapa sekarang adalah waktu yang tepat?
1. Mengapa Integrasi AI Kini Jauh Lebih Mudah#
Beberapa tahun lalu, menambahkan kecerdasan buatan ke aplikasi berarti mengumpulkan dataset, melatih model, mengelola server khusus, lalu memeliharanya. Hanya tim besar yang sanggup.
Sekarang pola kerjanya berubah. Penyedia model menawarkan kemampuan mereka lewat API: kamu mengirim teks lewat HTTP, lalu menerima jawaban. Dari sisi pengembang web, rasanya tidak jauh berbeda dari memanggil API pembayaran atau API peta.
Ada tiga perubahan yang membuat integrasi AI terasa ringan:
Pertama, model siap pakai lewat API. Gemini, misalnya, bisa dipanggil dari backend Node.js, Python, atau bahasa lain lewat SDK resmi. Kamu cukup menyimpan API key di server dan mengirim permintaan.
Kedua, model embedding tersedia sebagai layanan. Untuk mengubah teks menjadi vektor angka yang bisa dibandingkan maknanya, kamu tidak perlu membangun model sendiri. Cukup panggil endpoint embedding.
Ketiga, penyimpanan vektor sudah jadi fitur biasa. Kamu bisa memakai database vektor khusus, atau menambahkan ekstensi seperti pgvector ke PostgreSQL yang mungkin sudah kamu pakai. Dengan begitu data vektor tersimpan berdampingan dengan data aplikasi lainnya.
Dengan tiga bahan ini, satu orang developer bisa membangun fitur tanya-jawab cerdas dalam hitungan hari, bahkan jam untuk prototipe. Tetapi ada jebakan: model bahasa besar (LLM) punya keterbatasan mendasar yang akan kita bahas berikutnya.
2. Masalah Utama: Model AI Tidak Tahu Datamu#
LLM dilatih dari kumpulan teks yang sangat besar. Pengetahuan itu "tertanam" di dalam parameter model. Ini menimbulkan beberapa masalah praktis ketika kamu memakainya di aplikasi nyata.
a. Tidak punya data privat atau spesifik#
Model tidak tahu isi dokumen internal perusahaanmu, katalog produkmu, panduan pengguna aplikasimu, atau riwayat kariermu. Data itu tidak ada di dalam data latihnya. Kalau ditanya, ia bisa menolak, atau lebih berbahaya, ia mengarang.
b. Pengetahuan berhenti di titik waktu tertentu#
Setiap model punya batas waktu pengetahuan (knowledge cutoff). Apa pun yang terjadi sesudahnya tidak ia ketahui. Harga baru, kebijakan baru, fitur baru, semuanya luput.
c. Halusinasi#
Model dirancang untuk menghasilkan teks yang masuk akal secara statistik, bukan untuk memverifikasi kebenaran. Ketika informasi yang dibutuhkan tidak ia miliki, ia cenderung mengisi kekosongan dengan kalimat yang terdengar meyakinkan. Inilah yang sering disebut halusinasi.
d. Sulit ditelusuri sumbernya#
Peneliti yang memperkenalkan RAG sendiri menyoroti bahwa memberikan provenance (jejak asal informasi) untuk keputusan model dan memperbarui pengetahuan dunianya masih menjadi masalah terbuka. Dengan kata lain, jawaban murni dari parameter model sulit diaudit.
Semua masalah ini punya satu akar: model menjawab dari ingatannya, bukan dari dokumenmu. Dan di situlah RAG masuk.
3. Apa Itu RAG? Penjelasan Sederhana#
RAG (Retrieval-Augmented Generation) adalah pendekatan yang membuat model AI menjawab berdasarkan dokumen yang kita miliki, bukan hanya mengandalkan data latihnya.
Namanya sudah menjelaskan cara kerjanya:
- Retrieval: cari potongan informasi yang relevan dari sumber data milikmu.
- Augmented: perkaya (tambahkan) potongan itu ke dalam pertanyaan.
- Generation: minta model menghasilkan jawaban berdasarkan pertanyaan dan konteks tadi.
Analogi ujian buka buku#
Bayangkan dua mahasiswa menghadapi soal yang sama. Mahasiswa A harus menjawab hanya dari ingatan. Mahasiswa B boleh membuka buku catatan, tetapi hanya halaman yang relevan yang diletakkan di mejanya. Mahasiswa B hampir pasti memberi jawaban yang lebih akurat dan bisa menunjukkan halaman rujukannya.
RAG membuat model AI menjadi mahasiswa B. Sebelum menjawab, sistem mencarikan "halaman catatan" yang paling relevan, lalu model menjawab sambil membacanya.
Asal-usul singkat#
Istilah RAG dipopulerkan lewat makalah "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks" oleh Patrick Lewis dan rekan-rekan, yang diterima di NeurIPS 2020. Mereka menggabungkan memori parametrik (model bahasa yang sudah dilatih) dengan memori non-parametrik (indeks vektor padat dari Wikipedia yang diakses lewat retriever neural). Hasilnya, model RAG menghasilkan bahasa yang lebih spesifik, beragam, dan faktual dibanding model seq2seq yang hanya mengandalkan parameter, serta mencapai hasil terbaik pada tiga tugas tanya-jawab domain terbuka pada masanya.
Gagasan intinya bertahan sampai sekarang, hanya implementasinya yang menjadi jauh lebih sederhana. Untuk aplikasi web, kamu biasanya tidak melatih ulang model. Kamu cukup menyiapkan data, mengindeksnya, dan mengirim konteks yang tepat saat model dipanggil.
Apa untungnya?#
- Lebih akurat dan kontekstual: jawaban bersandar pada dokumen nyata.
- Mudah diperbarui: ganti atau tambah dokumen, tanpa melatih ulang model.
- Bisa menyertakan sumber: kamu tahu potongan mana yang dipakai, sehingga bisa menampilkan rujukan.
- Data tetap milikmu: dokumen disimpan di sistemmu dan hanya potongan relevan yang dikirim saat bertanya.
4. RAG vs Fine-Tuning vs Menempel Semua Dokumen ke Prompt#
Sebelum memilih RAG, wajar bertanya: tidakkah ada cara lain? Ada tiga pendekatan yang sering dibandingkan.
| Pendekatan | Cara kerja | Cocok untuk | Kelemahan |
|---|---|---|---|
| Prompt biasa | Bertanya langsung ke model | Pertanyaan umum | Tidak tahu data privat, rawan halusinasi |
| Menempel semua dokumen | Seluruh dokumen dimasukkan ke prompt | Data sangat kecil | Boros token, mahal, terbatas jendela konteks, jawaban bisa kurang fokus |
| Fine-tuning | Melatih ulang model dengan data tambahan | Mengubah gaya, format, atau perilaku | Mahal, lambat diperbarui, tidak ideal untuk fakta yang sering berubah |
| RAG | Cari potongan relevan, lalu kirim sebagai konteks | Tanya-jawab atas dokumen, basis pengetahuan, dukungan pelanggan | Butuh pipeline retrieval yang dirawat |
Ringkasnya: fine-tuning mengubah cara model berperilaku, RAG memberi model fakta yang tepat pada saat yang tepat. Untuk kebutuhan seperti chatbot portofolio, FAQ produk, atau panduan internal, RAG hampir selalu titik awal yang lebih masuk akal.
Menempel semua dokumen memang menggoda karena sederhana, dan untuk data yang sangat kecil bisa saja cukup. Namun begitu datamu bertambah, biaya naik dan kualitas bisa turun. Penelitian tentang penggunaan konteks panjang menunjukkan bahwa model cenderung kurang andal memanfaatkan informasi yang terletak di tengah konteks yang panjang (Liu dkk., "Lost in the Middle"). Mengirim sedikit potongan yang benar-benar relevan sering kali lebih baik daripada mengirim semuanya.
5. Anatomi RAG: Chunking, Embedding, dan Vector Database#
Ada tiga konsep yang perlu kamu pahami. Semuanya lebih sederhana daripada namanya.
Chunking: memecah konten menjadi potongan kecil#
Chunking adalah proses memecah dokumen panjang menjadi potongan-potongan kecil, misalnya per paragraf atau per beberapa kalimat. Mengapa tidak menyimpan dokumen utuh?
- Satu dokumen panjang biasanya membahas banyak topik. Vektor untuk keseluruhan dokumen akan "mengaburkan" semuanya.
- Potongan kecil membuat pencarian lebih presisi dan konteks yang dikirim ke model lebih hemat.
Beberapa pedoman praktis:
- Mulai dari potongan sekitar 150 sampai 400 kata, lalu sesuaikan dengan hasil uji.
- Pecah mengikuti struktur alami: judul, paragraf, atau butir daftar, bukan memotong di tengah kalimat.
- Tambahkan overlap kecil (misalnya satu sampai dua kalimat) agar makna tidak terputus di batas potongan.
- Sertakan metadata: judul bagian, sumber, tanggal, kategori. Metadata berguna untuk penyaringan dan untuk menampilkan rujukan.
Angka di atas bukan aturan baku. Jenis dokumenmu menentukan ukuran terbaik, jadi jadikan ukuran chunk sebagai parameter yang bisa kamu uji.
Embedding: mengubah makna menjadi angka#
Embedding adalah representasi teks dalam bentuk vektor, yaitu deretan angka, yang menangkap makna. Teks dengan makna mirip akan menghasilkan vektor yang berdekatan di ruang vektor, walaupun kata-katanya berbeda.
Contohnya, pertanyaan "Apa pengalaman kerja kamu?" dan paragraf "Saya pernah bekerja sebagai pengembang web di sebuah startup" tidak berbagi banyak kata yang sama, tetapi maknanya berdekatan. Pencarian berbasis embedding bisa menemukan keterkaitan itu, sesuatu yang sulit dilakukan pencarian kata kunci biasa.
Untuk Gemini, tersedia model embedding lewat API dan kamu bisa menentukan task type agar vektor dioptimalkan sesuai tujuan. Dua yang paling relevan untuk RAG adalah RETRIEVAL_DOCUMENT untuk dokumen yang akan diindeks, dan RETRIEVAL_QUERY untuk pertanyaan pengguna. Pasangkan keduanya: dokumen diindeks dengan satu tipe, pertanyaan di-embed dengan tipe pasangannya.
Vector database: rak arsip yang paham makna#
Vector database menyimpan vektor beserta teks dan metadatanya, lalu mampu mencari vektor yang paling dekat dengan vektor pertanyaan. Ukuran kedekatan yang umum adalah cosine similarity atau jarak kosinus.
Pilihanmu beragam. Kamu bisa memakai layanan vector database khusus, atau menambahkan ekstensi pgvector ke PostgreSQL. pgvector adalah ekstensi open-source untuk pencarian kemiripan vektor di Postgres: vektor disimpan bersama data lain, mendukung pencarian tetangga terdekat secara eksak maupun aproksimasi, serta jarak L2, inner product, dan cosine. Karena berjalan di Postgres, kamu mendapat juga fitur seperti transaksi ACID dan JOIN.
Untuk proyek kecil seperti portofolio dengan puluhan atau ratusan potongan teks, bahkan menyimpan vektor di database biasa lalu menghitung kemiripan di kode aplikasi pun sudah cukup. Jangan terburu-buru memilih infrastruktur besar sebelum datamu menuntutnya.
6. Alur Kerja RAG dari Awal sampai Jawaban#
Seluruh sistem RAG bisa dipahami sebagai dua fase.
Fase 1: Indexing (dilakukan sekali, atau saat data berubah)#
- Kumpulkan konten: dokumen, halaman, entri database, atau catatan.
- Pecah konten menjadi chunk dengan ukuran dan overlap yang masuk akal.
- Embed setiap chunk memakai model embedding (task type
RETRIEVAL_DOCUMENT). - Simpan vektor, teks asli, dan metadata ke vector store.
Fase 2: Query (dilakukan setiap pengguna bertanya)#
- Terima pertanyaan pengguna.
- Embed pertanyaan itu (task type
RETRIEVAL_QUERY). - Cari beberapa chunk paling dekat (top-k, misalnya 3 sampai 6).
- Susun prompt: instruksi, potongan konteks, lalu pertanyaan.
- Kirim ke model generatif (misalnya Gemini) dan kembalikan jawabannya, lengkap dengan rujukan bila perlu.
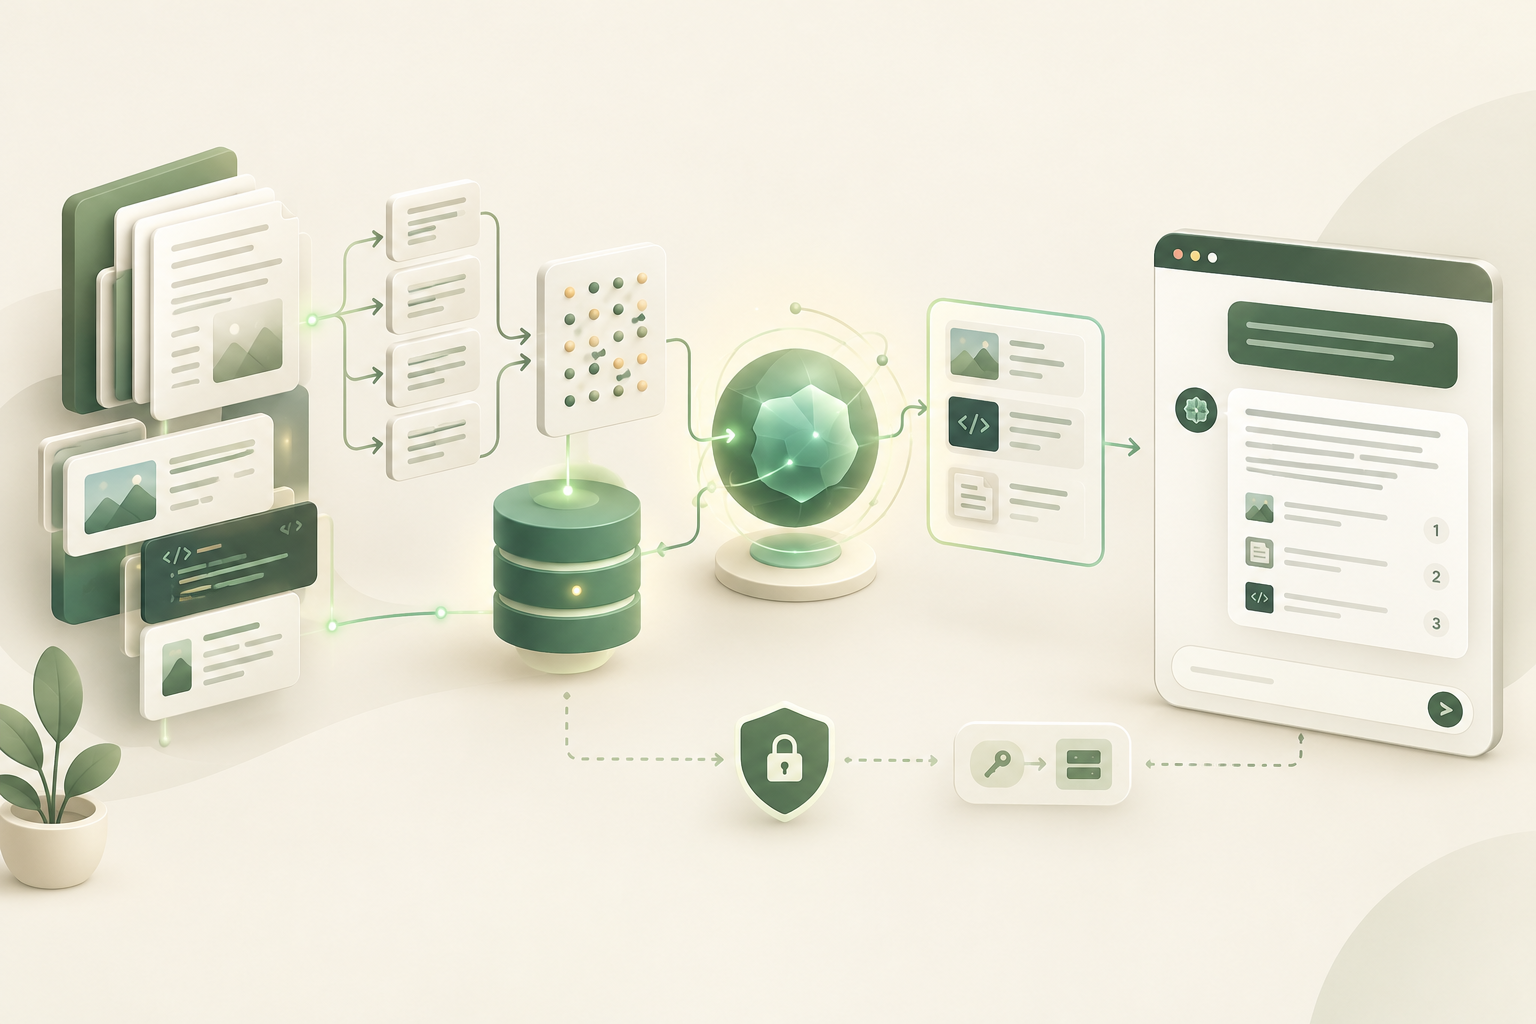
Secara singkat: konten dipecah menjadi potongan kecil, diubah menjadi embedding, lalu disimpan. Saat pengguna bertanya, kita cari potongan paling relevan, gabungkan dengan pertanyaan, lalu kirim ke model AI untuk menghasilkan jawaban. Itulah seluruh rahasianya. Sisanya adalah perincian dan penyempurnaan.
7. Studi Kasus: Chatbot Portofolio yang Menjawab Pengalaman dan Skill#
Agar konsepnya terasa nyata, mari lihat satu kasus: sebuah website portofolio dengan chatbot yang bisa menjawab pertanyaan tentang pengalaman dan skill pemiliknya.
Mengapa kasus ini bagus untuk belajar RAG?#
- Datanya kecil dan jelas: pengalaman kerja, proyek, skill, pendidikan, dan sertifikat.
- Kebenarannya mudah dicek: pemilik portofolio tahu persis mana jawaban yang benar dan mana yang karangan.
- Nilai praktisnya nyata: rekruter atau calon klien bisa bertanya langsung tanpa membaca semua halaman.
Pendekatan yang dipakai#
Di proyek portofolio ini, konsep yang sama diterapkan: data knowledge diambil dari database, di-embedding, lalu dijadikan konteks oleh Gemini. Artinya, pengetahuan chatbot tidak ditulis keras (hardcode) di dalam prompt, melainkan hidup di database. Ketika kamu menambah proyek baru atau memperbarui skill, chatbot ikut "tahu" setelah data tersebut diindeks ulang.
Contoh data knowledge#
Bayangkan tabel knowledge berisi entri seperti ini:
| kategori | judul | isi |
|---|---|---|
| pengalaman | Web Developer di Perusahaan X | Mengembangkan dashboard internal, merancang REST API, dan menulis pengujian. |
| proyek | Aplikasi Manajemen Tugas | Aplikasi web dengan autentikasi, notifikasi, dan antarmuka responsif. |
| skill | Frontend | React, TypeScript, Tailwind CSS. |
(Isi di atas hanya ilustrasi format data. Ganti dengan datamu sendiri.)
Bagaimana percakapannya berjalan#
Pengguna bertanya: "Pernah bikin API apa saja?" Sistem meng-embed pertanyaan, menemukan chunk tentang pengalaman dan proyek yang menyebut API, lalu menyusun prompt: "Jawab hanya berdasarkan konteks berikut..." Model Gemini kemudian menyusun jawaban yang bersandar pada entri tersebut, bukan pada tebakan.
Bandingkan dengan model tanpa konteks. Ia mungkin menjawab "Saya tidak punya informasi tentang itu" (aman tetapi tidak berguna), atau lebih buruk, menyebut proyek yang tidak pernah ada. Perbedaannya langsung terasa.
8. Implementasi Langkah demi Langkah#
Berikut kerangka implementasi yang bisa kamu adaptasi. Contoh memakai TypeScript/Node.js dengan SDK Google GenAI dan PostgreSQL + pgvector. Nama model dan parameter bisa berubah dari waktu ke waktu, jadi selalu cek dokumentasi resmi Gemini API sebelum memakainya di produksi.
Langkah 1: Siapkan database#
Dimensi (768 pada contoh) harus sama dengan dimensi embedding yang kamu hasilkan. Model embedding Gemini mendukung pengaturan dimensi keluaran, sehingga kamu bisa memilih ukuran yang seimbang antara kualitas dan penyimpanan. Gunakan satu dimensi yang konsisten untuk dokumen dan pertanyaan.
Langkah 2: Buat fungsi embedding#
Perhatikan dua hal. Pertama, taskType dibedakan antara dokumen dan pertanyaan. Kedua, API key dibaca dari environment variable di server, tidak pernah ditaruh di kode frontend.
Langkah 3: Indexing#
Jalankan skrip ini setiap kali datamu berubah. Untuk portofolio, cukup dijalankan manual atau lewat tombol admin.
Langkah 4: Retrieval#
Operator <=> pada pgvector menghitung jarak kosinus, jadi urutan menaik berarti paling mirip lebih dulu. Nilai score membantu kamu menolak hasil yang terlalu lemah.
Langkah 5: Generation#
Langkah 6: Bungkus dalam endpoint#
Buat route seperti POST /api/chat yang menerima pertanyaan, memanggil answer(), dan mengembalikan JSON. Frontend hanya berkomunikasi dengan endpoint ini. Semua rahasia (API key, kredensial database) tetap di server.
Sampai di sini kamu sudah punya RAG yang berfungsi. Bagian berikutnya membahas hal yang membedakan prototipe asal jadi dari fitur yang bisa diandalkan.
9. Merancang Prompt yang Membuat Model Patuh pada Konteks#
Retrieval yang bagus bisa sia-sia jika prompt-nya longgar. Prompt pada RAG punya tugas utama: mengikat model pada konteks yang kamu berikan. Istilah umumnya adalah grounding.
Komponen prompt RAG yang sehat#
- Peran: siapa asisten ini dan untuk siapa ia menjawab.
- Aturan sumber: jawab hanya dari konteks. Jika tidak ada, akui dengan jujur.
- Gaya: bahasa, panjang jawaban, dan nada yang diinginkan.
- Konteks: potongan hasil retrieval, diberi nomor dan judul.
- Pertanyaan: ditempatkan jelas dan terpisah dari konteks.
Contoh pola yang bisa kamu pakai#
Tips tambahan#
- Beri izin untuk berkata tidak tahu. Model yang tidak diberi pilihan itu cenderung mengarang. Kalimat "akui jika tidak ada" sering menurunkan halusinasi secara nyata.
- Pisahkan instruksi dari data. Tempatkan konteks di blok tersendiri agar model tidak salah mengira isi dokumen sebagai perintah.
- Atur panjang. Minta jawaban singkat untuk chatbot di halaman web, dan lebih rinci hanya jika pengguna meminta.
- Simpan riwayat percakapan secukupnya. Pertanyaan lanjutan seperti "kalau yang tadi pakai teknologi apa?" butuh konteks percakapan. Satu teknik yang umum adalah menulis ulang pertanyaan lanjutan menjadi pertanyaan mandiri sebelum melakukan retrieval.
10. Mengukur dan Meningkatkan Kualitas Jawaban#
Banyak proyek RAG berhenti di tahap "kelihatannya jalan". Padahal kualitas harus diukur, kalau tidak, setiap perubahan hanya berdasarkan perasaan.
Pisahkan dua pertanyaan#
Ketika jawaban buruk, tanyakan lebih dulu: apakah retrieval gagal, atau generation yang gagal?
- Jika potongan yang benar tidak ikut terambil, masalahnya ada di chunking, embedding, atau pencarian.
- Jika potongan yang benar sudah terambil tetapi jawaban tetap salah, masalahnya ada di prompt atau pilihan model.
Dengan memisahkan keduanya, kamu tidak menghabiskan waktu menyetel prompt untuk masalah yang sebenarnya ada di chunking.
Buat set uji kecil#
Tulis 20 sampai 30 pertanyaan yang realistis beserta jawaban yang kamu anggap benar. Untuk chatbot portofolio, contohnya:
- "Apa skill utama kamu di frontend?"
- "Pernah mengerjakan proyek apa yang melibatkan API?"
- "Pendidikan terakhirnya apa?"
- Pertanyaan jebakan yang jawabannya tidak ada di data, misalnya "Berapa ekspektasi gajinya?" Chatbot yang baik akan mengakui tidak tahu.
Jalankan set ini setiap kali kamu mengubah ukuran chunk, jumlah top-k, atau prompt. Catat berapa yang terjawab benar. Ini kebiasaan kecil yang membedakan pengembang yang menebak dari pengembang yang bekerja berdasarkan bukti.
Tuas penyetelan yang paling berpengaruh#
| Tuas | Jika terlalu kecil | Jika terlalu besar |
|---|---|---|
| Ukuran chunk | Konteks terpotong, makna hilang | Vektor kabur, token boros |
| Overlap | Informasi terputus di batas chunk | Duplikasi dan biaya naik |
| Top-k | Informasi penting terlewat | Konteks berisik, jawaban melebar |
| Ambang skor | Banyak hasil lemah ikut terkirim | Terlalu sering menjawab "tidak tahu" |
Peningkatan lanjutan saat dibutuhkan#
- Pencarian hibrida: gabungkan pencarian kata kunci dan pencarian vektor, berguna untuk istilah teknis, nama produk, atau singkatan yang sulit ditangkap embedding.
- Re-ranking: ambil kandidat lebih banyak (misalnya 20), lalu urutkan ulang agar yang paling relevan berada di atas.
- Penyaringan metadata: batasi pencarian ke kategori tertentu, misalnya hanya "proyek" saat pertanyaan menyangkut proyek.
- Pembaruan inkremental: hanya embed ulang chunk yang berubah, bukan seluruh data.
Jangan menerapkan semuanya sekaligus. Mulai dari versi paling sederhana, ukur, lalu tambahkan teknik hanya ketika hasil uji menunjukkan kebutuhan.
11. Keamanan dan Privasi pada Aplikasi RAG#
Begitu chatbot terhubung ke internet, ia menjadi permukaan serangan. Beberapa hal berikut wajib kamu pertimbangkan sejak awal.
a. Lindungi API key dan kredensial#
Simpan kunci di environment variable server. Jangan pernah mengirimnya ke browser. Semua panggilan ke Gemini sebaiknya lewat endpoint backend milikmu, dengan pembatasan laju (rate limiting) agar tagihan tidak jebol oleh penyalahgunaan.
b. Waspadai prompt injection#
OWASP, komunitas keamanan aplikasi yang terkenal, menempatkan prompt injection sebagai risiko nomor satu dalam daftar Top 10 untuk aplikasi LLM. Intinya, masukan yang dibuat khusus dapat memengaruhi atau menimpa perilaku model yang seharusnya. Ada dua bentuk: injeksi langsung, ketika pengguna sendiri mengetik perintah jahat, dan injeksi tidak langsung, ketika instruksi tersembunyi berada di dalam konten eksternal yang dibaca model, misalnya dokumen atau halaman web.
Pada RAG, bentuk kedua penting: dokumen yang kamu indeks ikut menjadi masukan bagi model. Jika datamu berasal dari sumber yang tidak sepenuhnya kamu kontrol (hasil unggahan pengguna, hasil scraping), isinya bisa mengandung instruksi terselubung.
Langkah mitigasi yang masuk akal:
- Perlakukan konteks dan input pengguna sebagai data tidak tepercaya.
- Beri instruksi sistem yang tegas dan pisahkan dengan jelas dari konteks.
- Jangan beri chatbot kemampuan yang tidak perlu. Chatbot portofolio cukup membaca dan menjawab, tidak perlu mengeksekusi aksi atau mengakses data lain.
- Periksa dan batasi keluaran sebelum ditampilkan, terutama jika dirender sebagai HTML. Jangan menganggap jawaban model otomatis aman.
- Catat (log) percakapan secara bertanggung jawab untuk mendeteksi pola penyalahgunaan.
Perlu dicatat, belum ada solusi tunggal yang menjamin prompt injection hilang sepenuhnya. Karena itu pendekatan yang tepat adalah pertahanan berlapis dan pembatasan dampak, bukan berharap satu filter cukup.
c. Jaga privasi data#
- Jangan mengindeks data pribadi yang tidak perlu (nomor identitas, alamat rumah, kontak pribadi) ke knowledge base publik.
- Jika aplikasi melayani banyak pengguna dengan dokumen berbeda, terapkan kontrol akses pada tahap retrieval: filter chunk berdasarkan hak akses pengguna sebelum dikirim ke model. Jangan mengandalkan model untuk "merahasiakan" sesuatu.
- Pahami kebijakan penyedia layanan model tentang penggunaan dan retensi data yang kamu kirim, lalu sesuaikan dengan kebutuhan privasi proyekmu.
12. Performa, Biaya, dan Deployment#
Prototipe yang menyenangkan bisa berubah menjadi tagihan yang mengejutkan. Beberapa kebiasaan berikut menjaga sistem tetap cepat dan hemat.
Hemat panggilan embedding#
- Embed dokumen sekali saat indexing, bukan setiap permintaan.
- Embed beberapa teks sekaligus (batch) bila API mendukungnya.
- Cache embedding untuk pertanyaan yang sering muncul.
Hemat token generasi#
- Kirim top-k yang secukupnya. Lebih banyak konteks berarti biaya dan latensi lebih besar, dan belum tentu jawaban lebih baik.
- Batasi panjang jawaban lewat prompt dan parameter model.
- Pilih model yang sesuai kebutuhan. Untuk tanya-jawab sederhana, varian yang cepat dan murah biasanya sudah memadai. Cek halaman harga resmi karena tarif dan nama model bisa berubah.
Perbaiki pengalaman pengguna#
- Gunakan streaming agar jawaban muncul bertahap, sehingga terasa responsif.
- Tampilkan indikator mengetik dan tangani kegagalan dengan pesan yang ramah.
- Tampilkan sumber di bawah jawaban. Ini menambah kepercayaan, sekaligus memudahkan pengguna memeriksa kebenarannya.
Deployment#
- Jalankan logika RAG di sisi server (API route, serverless function, atau service terpisah).
- Pastikan environment variable terkonfigurasi di platform hosting.
- Siapkan monitoring: catat latensi, error, dan pertanyaan yang tidak terjawab. Pertanyaan yang gagal adalah daftar tugas terbaik untuk memperbaiki datamu.
13. Kesalahan Umum yang Sering Terjadi#
Berikut jebakan yang paling sering dijumpai saat membangun RAG pertama kali.
- Memotong chunk sembarangan. Memecah di tengah kalimat atau memisahkan judul dari isinya membuat retrieval tidak akurat. Pecah mengikuti struktur dokumen.
- Memakai dimensi atau model embedding yang berbeda antara indexing dan query. Hasil pencarian menjadi tidak bermakna. Pastikan keduanya konsisten.
- Lupa membedakan task type pada embedding, padahal model menyediakannya untuk dokumen dan pertanyaan.
- Mengirim terlalu banyak konteks. Lebih banyak bukan berarti lebih baik. Konteks berisik membuat model kehilangan fokus.
- Tidak ada instruksi "akui jika tidak tahu". Hasilnya chatbot mengarang saat datanya kosong.
- Data basi. Knowledge base yang tidak diperbarui akan membuat chatbot menjawab dengan benar tentang hal yang sudah tidak berlaku.
- Tidak pernah menguji. Tanpa set uji, kamu tidak tahu apakah perubahan terakhir membantu atau merusak.
- Menaruh API key di frontend. Ini kesalahan keamanan paling mahal dan paling mudah dicegah.
- Mengabaikan pertanyaan jebakan. Uji juga pertanyaan di luar cakupan data, karena di sanalah halusinasi paling sering muncul.
- Terlalu cepat memilih infrastruktur rumit. Untuk ratusan chunk, solusi sederhana sudah cukup. Kompleksitas ditambahkan ketika data dan trafik menuntutnya.
14. Coba Sekarang: Prototipe RAG dalam 30 Menit#
Teori hanya akan menempel kalau dipraktikkan. Kalau kamu penasaran, coba buat prototipe kecil: ambil beberapa paragraf tulisanmu, masukkan ke vector store, lalu tanyakan sesuatu. Perbedaannya akan langsung terasa dibanding model yang menjawab tanpa konteks.
Berikut rencana praktisnya.
Menit 0 sampai 5: Siapkan bahan#
- Pilih 5 sampai 10 paragraf dari tulisanmu sendiri: artikel blog, catatan kuliah, atau deskripsi proyek.
- Buat API key Gemini dan simpan sebagai environment variable.
Menit 5 sampai 15: Indexing#
- Pecah paragraf menjadi chunk (satu paragraf satu chunk sudah cukup untuk percobaan).
- Panggil fungsi
embed()dengan task typeRETRIEVAL_DOCUMENT. - Simpan vektor dan teks. Untuk percobaan, cukup array di memori atau file JSON, belum perlu database.
Menit 15 sampai 25: Retrieval dan jawaban#
- Embed pertanyaanmu dengan
RETRIEVAL_QUERY. - Hitung kemiripan kosinus ke semua chunk, ambil 3 teratas.
- Susun prompt dengan aturan "jawab hanya dari konteks", lalu kirim ke Gemini.
Fungsi kemiripan kosinus yang bisa kamu pakai untuk prototipe tanpa database:
Menit 25 sampai 30: Bandingkan#
Ajukan pertanyaan yang sama dua kali: sekali langsung ke model tanpa konteks, sekali lewat pipeline RAG. Perhatikan perbedaannya: kekhususan jawaban, kesesuaian dengan tulisanmu, dan apakah model mengarang atau mengakui keterbatasan. Coba juga satu pertanyaan yang jawabannya sengaja tidak ada di tulisanmu.
Begitu kamu merasakan sendiri bedanya, sisanya adalah soal merapikan: database, antarmuka, keamanan, dan pengujian.
Dari Prototipe ke Produk#
Kita mulai dari sebuah chatbot yang menjawab dengan percaya diri tetapi salah. Kita akhiri dengan pemahaman bahwa masalah itu bisa diatasi tanpa sihir.
Ringkasan perjalanannya:
- AI di aplikasi web sekarang terjangkau. API seperti Gemini membuat kemampuan model bahasa bisa dipanggil layaknya layanan web biasa.
- RAG membuat model menjawab dari dokumenmu. Hasilnya lebih akurat, kontekstual, mudah diperbarui, dan bisa ditelusuri sumbernya.
- Alurnya sederhana. Konten dipecah menjadi chunk, diubah menjadi embedding, disimpan di vector store. Saat ada pertanyaan, potongan paling relevan dicari, digabung dengan pertanyaan, lalu dikirim ke model.
- Kualitas lahir dari pengukuran. Pisahkan masalah retrieval dari masalah generation, dan bangun set uji kecil sejak awal.
- Keamanan bukan tambahan. Lindungi kunci, waspadai prompt injection, dan batasi akses data pada tahap retrieval.
Proyek portofolio dengan chatbot yang bisa menjawab pertanyaan tentang pengalaman dan skill adalah tempat latihan yang ideal: datanya kecil, kebenarannya mudah diperiksa, dan manfaatnya langsung terlihat oleh pengunjung. Dari sana, pola yang sama bisa kamu bawa ke kasus yang lebih besar: pusat bantuan produk, asisten dokumentasi, tanya-jawab kebijakan internal, atau pencarian pintar di aplikasi bisnis.
Langkah berikutnya sederhana. Pilih satu data milikmu, luangkan 30 menit, dan bangun prototipe kecil itu hari ini. Satu percobaan nyata akan mengajarkan lebih banyak daripada sepuluh artikel. Dan ketika chatbotmu pertama kali menjawab dengan tepat sesuatu yang hanya ada di tulisanmu, kamu akan paham mengapa RAG layak dipelajari.
Selamat membangun.
FAQ#
Apa bedanya RAG dengan fine-tuning?#
Fine-tuning melatih ulang model agar perilakunya berubah, sedangkan RAG memberi model informasi yang relevan pada saat pertanyaan diajukan. Untuk fakta yang sering berubah atau dokumen yang harus bisa dirujuk, RAG biasanya lebih praktis dan lebih mudah diperbarui.
Apakah RAG menjamin tidak ada halusinasi?#
Tidak. RAG menurunkan risiko karena jawaban bersandar pada dokumen, tetapi model tetap bisa keliru jika retrieval gagal atau prompt longgar. Karena itu pengujian, instruksi "akui jika tidak tahu", dan penampilan sumber tetap penting.
Apakah saya perlu vector database khusus?#
Belum tentu. Untuk data kecil, penyimpanan sederhana sudah cukup. Jika kamu sudah memakai PostgreSQL, ekstensi pgvector adalah pilihan yang wajar. Layanan vector database khusus baru terasa perlu saat skala data dan trafik besar.
Berapa ukuran chunk yang ideal?#
Tidak ada angka tunggal. Titik awal yang umum adalah beberapa ratus kata dengan sedikit overlap, lalu sesuaikan dengan hasil uji pada datamu sendiri.
Apakah data saya aman saat dikirim ke API model?#
Tergantung kebijakan penyedia dan cara kamu merancang sistem. Kirim hanya potongan yang diperlukan, hindari data pribadi yang tidak relevan, terapkan kontrol akses sebelum retrieval, dan baca ketentuan penggunaan data dari penyedia model yang kamu pilih.
Bisakah chatbot RAG menyebutkan sumber jawabannya?#
Bisa. Karena setiap potongan konteks punya judul dan metadata, kamu bisa menomorinya di prompt dan meminta model menyebut nomor yang dipakai, lalu menampilkannya sebagai rujukan di antarmuka.
Bahasa pemrograman apa yang cocok?#
Hampir semua bahasa bisa. Contoh di artikel ini memakai TypeScript/Node.js, tetapi Python, PHP, Go, dan lainnya juga punya SDK atau dapat memanggil API lewat HTTP.
Sumber dan Referensi#
Semua tautan di bawah diakses pada Oktober 2026. Nama model, parameter, dan fitur API dapat berubah, jadi selalu cocokkan dengan dokumentasi terbaru.
Makalah dan riset
- Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., Kiela, D. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020. https://arxiv.org/abs/2005.11401
- Karpukhin, V., dkk. (2020). Dense Passage Retrieval for Open-Domain Question Answering. https://arxiv.org/abs/2004.04906
- Liu, N. F., dkk. (2023). Lost in the Middle: How Language Models Use Long Contexts. https://arxiv.org/abs/2307.03172
Dokumentasi teknis
- Google AI for Developers. Gemini API: Embeddings (task type, model embedding, dimensi keluaran). https://ai.google.dev/gemini-api/docs/embeddings
- Google AI for Developers. Gemini API Documentation. https://ai.google.dev/gemini-api/docs
- Qdrant. Gemini Embeddings Integration (contoh
RETRIEVAL_DOCUMENTdanRETRIEVAL_QUERY). https://qdrant.tech/documentation/embeddings/gemini/ - pgvector. Open-source vector similarity search for Postgres. https://github.com/pgvector/pgvector
Keamanan
- OWASP GenAI Security Project. OWASP Top 10 for LLM Applications (LLM01: Prompt Injection). https://genai.owasp.org/llm-top-10/
SEO dan penulisan
- Google Search Central. SEO Starter Guide. https://developers.google.com/search/docs/fundamentals/seo-starter-guide
Catatan: contoh data pada studi kasus (Web Developer di Perusahaan X, dan sebagainya) hanyalah ilustrasi format. Ganti dengan data pengalaman dan skill aslimu sebelum dipublikasikan.